Sommaire (8 sections)
- Pourquoi maintenant, et pourquoi Wazuh
- Dimensionner : les trois choses que l'installeur ne fait pas
- 38 agents en trois vagues, et un pilote d'abord
- Le calibrage : de 1 250 alertes à 8
- Trois sorties, un seuil chacune
- Les détections qui comptent vraiment
- SSO à deux couches, et un compte local qui reste
- Ce qui reste ouvert
Chaque serveur produit des journaux. Tant qu'ils restent sur la machine, ils ne servent qu'à une chose : comprendre après coup, à condition que l'attaquant n'ait pas pris la peine de les effacer. Un SIEM déplace ces journaux hors de portée, les corrèle, et transforme des lignes en questions auxquelles on peut répondre : cette clé SSH a-t-elle été ajoutée par nous ? Cette adresse bannie a-t-elle fini par entrer ? Nous avons intégré Wazuh sur l'ensemble de notre parc en septembre. Voici le dispositif, et surtout ce qui s'est passé entre l'installation et un outil réellement lisible.
Pourquoi maintenant, et pourquoi Wazuh #
Trois raisons se sont alignées. Le bastion venait de centraliser tous les accès : ses traces méritaient mieux qu'un disque local. Notre auto-audit ANSSI pointait la journalisation centralisée comme une mesure d'hygiène non couverte, avec une recommandation de conservation de six mois à un an. Et le RGPD (article 32) attend d'un hébergeur qu'il puisse détecter et documenter une violation, pas seulement la subir. Wazuh s'est imposé parce qu'il est open source, complet (collecte, détection, intégrité de fichiers, vérification de conformité, réponse), et qu'il fonctionne avec un agent léger sur chaque machine. Nous avons volontairement gardé la branche 4.x plutôt que la toute nouvelle majeure, non recommandée en production au moment du choix.
Dimensionner : les trois choses que l'installeur ne fait pas #
Une VM dédiée, 8 vCPU, 16 Go de RAM, 250 Go, avec deux pattes réseau : une sur le réseau interne, une sur le bloc public. Sans la seconde, les trente agents internes sortiraient par la passerelle et apparaîtraient tous sous la même adresse dans un outil dont le métier est précisément de dire d'où vient quoi. Le pare-feu de l'hyperviseur a été écrit avant le premier démarrage (le piège du firewall déclaré mais inopérant), et aucun service n'est public à l'exception du port nécessaire au renouvellement du certificat ; la console est restreinte à deux adresses. L'installeur automatique fait le reste, sauf trois choses que nous avons dû corriger nous-mêmes :
- La mémoire de l'indexeur est fixée à 1 Go quelle que soit la RAM de la machine. Sur 16 Go, c'est une machine qui rame puis cale. Passée à 8 Go, bornes minimale et maximale identiques.
- Aucune politique de rétention n'existe par défaut : les index grossissent indéfiniment. Nous avons posé douze mois pour les alertes, quatre-vingt-dix jours pour les index techniques, avec purge automatique. La rétention est une décision documentée (registre RGPD), pas un accident de disque plein.
- Les archives brutes sont à désactiver : elles conservent tous les événements, pas seulement les alertes, et font exploser le stockage sans valeur d'enquête proportionnelle.
38 agents en trois vagues, et un pilote d'abord #
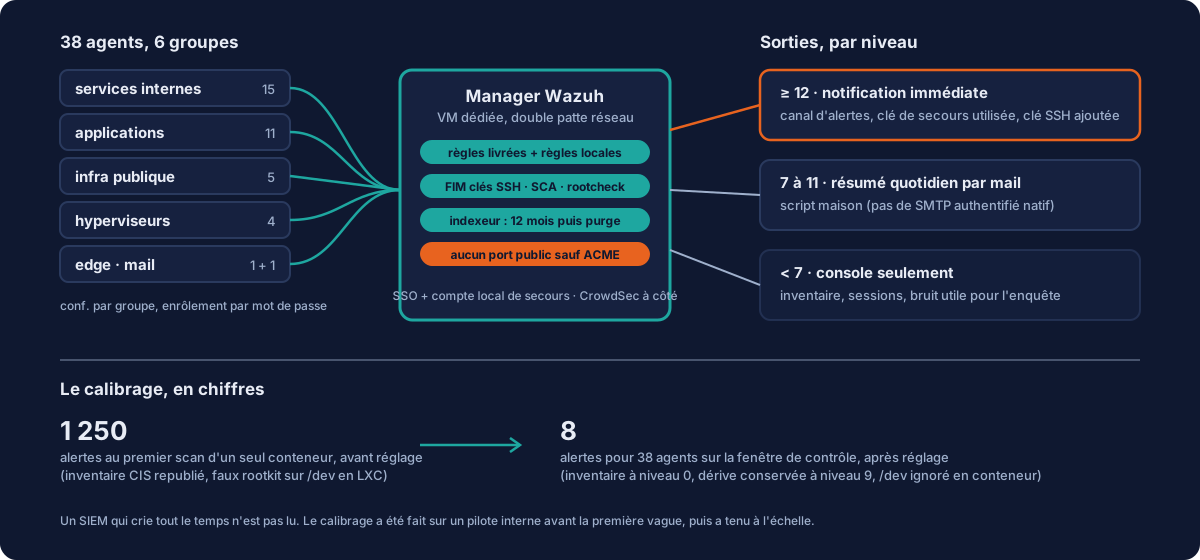
Avant le premier agent, le manager a été préparé : six groupes (services internes, applications, infrastructure publique, hyperviseurs, edge, mail), parce que la configuration se pilote par groupe et que tout mettre dans le groupe par défaut interdit de différencier ensuite. Et une découverte désagréable : l'enrôlement n'exigeait aucun mot de passe. N'importe quelle machine du réseau interne pouvait s'inscrire comme agent. Corrigé avant la première vague. Le pilote fut un conteneur interne sans aucun enjeu client : meilleur choix qu'une application de production pour mesurer ce qu'un agent produit réellement.
Le calibrage : de 1 250 alertes à 8 #
Le premier scan du pilote, un seul conteneur, a produit 1 250 alertes. Extrapolé aux 38 machines, c'était 47 000 alertes au seul enrôlement, et un outil que personne n'ouvrirait plus jamais. L'analyse par règle a montré que le contrôle de conformité CIS n'était que 30 % du bruit. Le vrai faux positif venait du rootcheck en conteneur : il prend les fichiers de fonctionnement d'un LXC dans /dev pour des indices de rootkit, au niveau 7. Environ 2 500 alertes vides attendues sur nos 26 conteneurs.
La bonne pratique n'est pas de désactiver les modules. Le jeu de règles livré sépare déjà l'état de la dérive : les règles qui republient l'inventaire de conformité à chaque scan ont été abaissées au niveau 0, tandis que celles qui signalent un contrôle passé de réussi à échoué restent au niveau 9. La console de conformité reste alimentée, ses résultats vivant dans une base séparée de l'index d'alertes. Le rootcheck sur /dev a été coupé pour les groupes contenant des conteneurs, et seulement eux : les neuf machines publiques ont un noyau propre et n'ont pas ce faux positif. Résultat mesuré, parc complet : 8 alertes pour 38 agents sur la fenêtre de contrôle, toutes issues de nos propres connexions.
Trois sorties, un seuil chacune #
Un SIEM sans destinataire est un disque qui se remplit. Notre doctrine tient au seuil, plus qu'au canal : niveau 12 et plus, notification immédiate dans le canal d'alertes de l'équipe ; 7 à 11, résumé quotidien par mail à sept heures ; en dessous, console seulement. Le résumé a exigé un script maison, parce que Wazuh ne sait pas faire d'authentification SMTP et attend un relais local, ce qui contredit notre doctrine de mail sortant par API authentifiée. Et chaque sortie a été prouvée de bout en bout avec une règle temporaire de niveau 12 déclenchée par une ligne de journal factice, puis retirée : la recette pour tester une sortie sans attendre un vrai incident.
Les détections qui comptent vraiment #
- Toute modification d'un fichier
authorized_keyssur les 38 machines, en temps réel, avec le diff dans l'alerte (niveau 14). C'est la réponse à « quelqu'un a gagné une clé quelque part » : l'angle que le bastion ne couvre pas. - L'usage de la clé de secours hors ligne, reconnue par son empreinte dans une authentification réussie : niveau 15, le maximum. Elle ne doit jamais servir sans qu'on le sache.
- La conformité de cette clé de secours, par une politique de vérification maison : les machines publiques doivent la porter, les conteneurs internes ne le doivent pas. Un tableau de bord dédié affiche l'état de chaque machine, alimenté toutes les heures.
- La corrélation CrowdSec : adresse bannie puis connexion SSH réussie, niveau 13.
SSO à deux couches, et un compte local qui reste #
La console est branchée sur notre IdP, mais Wazuh a deux couches d'autorisation : le mappage de rôles de l'indexeur, et le contrôle d'accès de l'API du manager, parce que le tableau de bord propage le contexte de l'utilisateur. Sans règle dans la seconde, on est connecté et l'application est vide, avec une erreur générique. Et le fichier de mappage sur disque ne fait rien tant qu'il n'est pas poussé dans l'index de sécurité : vérifiez par l'API, jamais en lisant le YAML. Le compte local d'administration reste actif à côté du SSO : jamais de SSO exclusif sur un SIEM, c'est l'outil qu'on ouvre quand le reste va mal.
Ce qui reste ouvert #
Nous le disons parce que c'est vrai : la VM du SIEM n'a pas encore de réplication de stockage entre nœuds, donc sa reprise passe par la sauvegarde, avec un retard possible. Le déploiement des agents a été fait à la main en trois vagues et doit devenir un rôle d'automatisation pour que tout nouvel hôte soit enrôlé sans y penser (voir notre cycle de vie des machines). Les machines louées à des clients qui les administrent eux-mêmes sont hors périmètre, par choix. Et la question que tout SIEM finit par poser reste la nôtre : qui lit les alertes. Le seuil et le résumé quotidien sont notre réponse ; ils seront ajustés à l'usage.
Détecter une clé ajoutée en pleine nuit, rejouer un accès, prouver douze mois de journaux à un auditeur : c'est concrètement ce que recouvre notre infogérance au-delà de l'hébergement. Si vos journaux ne quittent jamais la machine qui les produit, parlons-en.