Sommaire (9 sections)
- 1. Échantillonner : quels commits méritent d'être racontés
- 2. Reconstruire : le problème n'est pas le code, c'est l'époque
- Les quatre pièges qui coûtent le plus de temps
- 3. Photographier : le piège du défilement interne
- 4. Compter est le travail de Git, pas celui d'un modèle
- 5. Raconter, puis vérifier
- Ce que l'exécution a trouvé et que la relecture n'avait pas vu
- Le jalon qui n'a jamais démarré
- Ce que ça coûte, ce que ça rapporte
Il y a une question à laquelle presque aucune équipe ne sait répondre avec des preuves : à quoi ressemblait le produit il y a dix-huit mois ? Les maquettes ont été écrasées, les captures d'écran traînent dans des fils de discussion, l'environnement de recette a été recréé trois fois. Pourtant l'information existe, intacte, à quelques mètres de là : dans le dépôt Git.
Nous avons écrit un outil qui l'exploite. Il parcourt l'historique, choisit des jalons, reconstruit chacun d'eux dans des conteneurs avec le SDK et la base de données de son époque, lance l'application, photographie ses pages, compte les faits avec Git, puis compose un document. Il a tourné sur deux ans d'historique de la plateforme BuyStep et produit vingt-cinq captures réelles. Voici comment il est fait, et surtout ce qu'il a fallu résoudre.
1. Échantillonner : quels commits méritent d'être racontés #
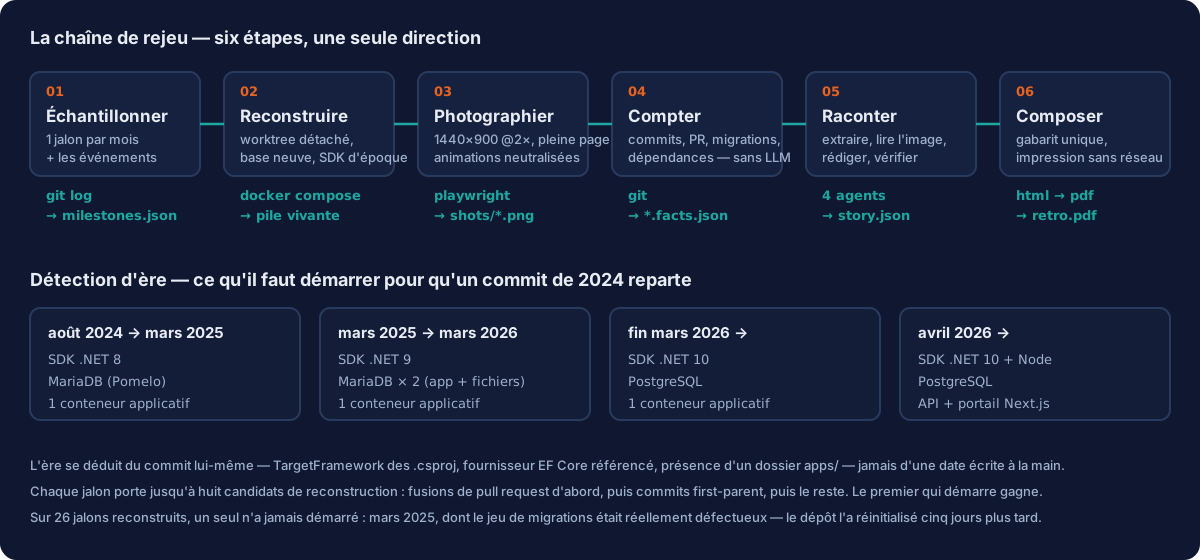
Rejouer 1 700 commits n'aurait aucun sens. La règle retenue est volontairement bête : un jalon par mois, plus un jalon par événement déclaré — changement de version du framework, migration de moteur de base de données, naissance d'un portail. Un jalon mensuel situé à moins de sept jours d'un événement est supprimé, pour ne pas raconter deux fois la même semaine.
Deux détails font toute la différence à l'usage. D'abord, les fenêtres d'analyse sont contiguës et sans recouvrement : chaque commit de l'historique appartient à exactement un jalon, sinon les chiffres se comptent deux fois. Ensuite, chaque jalon porte plusieurs candidats de reconstruction, classés par probabilité de compiler : les fusions de pull request d'abord, puis les commits first-parent, puis le reste. Le premier qui démarre gagne.
2. Reconstruire : le problème n'est pas le code, c'est l'époque #
Extraire un commit est trivial. Le faire démarrer ne l'est pas : le SDK de l'époque n'est plus celui installé, le moteur de base de données a changé, et les paquets référencés ne s'installent pas tous de la même façon. La séquence pour chaque candidat :
git worktree add --detach <tmp>/<sha> <sha>   # espace de travail jetable, le dépôt n'est jamais modifié
# détection d'ère : TargetFramework des .csproj, fournisseur EF Core référencé, présence d'un dossier apps/
docker compose -f compose.<moteur>.yml up -d   # base neuve, volume anonyme, port dédié
docker run --rm -v nuget-cache:/root/.nuget <sdk-de-l-epoque> dotnet publish
dotnet ef database update                      # les migrations de l'époque, pas celles d'aujourd'hui
# amorçage tolérant au schéma, puis conteneur d'exécution, puis sonde de disponibilité
La détection d'ère est le cœur du dispositif, et elle se déduit du commit lui-même — jamais d'une date écrite en dur. Sur BuyStep, elle distingue quatre périodes : .NET 8 sur MySQL, .NET 9 sur MySQL, .NET 9 avec deux bases distinctes (l'application et les fichiers), puis .NET 10 sur PostgreSQL avec un portail Node à partir d'avril 2026.
L'amorçage des données doit être tolérant au schéma : le jeu de données de 2026 ne s'insère pas dans les tables de 2024. Concrètement, chaque insertion est tentée puis ignorée si la colonne n'existe pas encore. C'est laid, c'est la seule chose qui marche sur vingt-cinq schémas différents.
Les quatre pièges qui coûtent le plus de temps #
- Les secrets devenus obligatoires. Une application qui démarrait sans clé de paiement en 2024 refuse de démarrer en 2026, parce qu'un service a commencé à exiger la variable. La solution n'est pas de fournir un vrai secret, c'est de fournir une valeur au bon format : les pages s'affichent, seul un appel réel échouerait.
- Les licences de paquets. Une bibliothèque de mappage passée en licence payante vérifie un jeton au démarrage. Sur la fenêtre concernée, une valeur bidon ne suffit pas : il faut la vraie clé, ou ces jalons ne démarrent pas. À nommer explicitement dans les messages d'erreur, sinon on cherche pendant une heure.
- Les dépendances qui tuent le processus. Un service d'indexation qui arrête l'application quand son moteur de recherche est absent transforme un jalon reconstructible en échec silencieux. Il faut soit démarrer le service, soit neutraliser son initialisation.
- Les ports. Une base de données de développement déjà lancée sur la machine, et la pile reconstruite se connecte à la mauvaise. Ports dédiés, configurables, et jamais ceux du projet.
3. Photographier : le piège du défilement interne #
Les captures sont prises pendant que la pile tourne, en 1440 × 900 à double densité, page entière, animations neutralisées, avec un défilement complet préalable pour déclencher le chargement différé des images. Chaque fichier est accompagné d'un frère .meta.json : statut, hauteur réelle de la page, longueur du texte du document, notes.
Cette hauteur réelle n'est pas décorative : c'est un indicateur de produit. Sur BuyStep, elle passe de 11 620 pixels en août 2024 à 5 514 en avril 2025, remonte à 13 624 un mois plus tard, atteint 15 110 au printemps 2026, puis redescend à 8 302 en août 2026. La série des hauteurs raconte l'histoire éditoriale du site à elle seule.
4. Compter est le travail de Git, pas celui d'un modèle #
C'est la décision de conception dont nous sommes le plus satisfaits. Avant toute intervention d'un modèle de langage, une étape gratuite et hors-ligne produit les faits chiffrés de chaque fenêtre :
# commits par auteur, journée la plus chargée, commits nocturnes, reverts, PR fusionnées
git log --no-merges --pretty=format:%H%x09%an%x09%aI%x09%s <depuis>..<jusqua>
# migrations ajoutées, deltas de dépendances, zones du dépôt touchées
git diff --name-status <depuis>..<jusqua>
git diff <depuis>..<jusqua> -- "*.csproj" "package.json"
Le fichier de faits ainsi produit est ensuite donné aux agents. Ils n'ont plus qu'à choisir ce qui mérite d'être raconté et à le formuler. Un modèle à qui l'on demande de compter des commits dans un journal se trompe ; un modèle à qui l'on fournit le compte ne peut pas se tromper dessus. La frontière est simple à tenir : ce qui est vérifiable mécaniquement ne doit jamais transiter par un modèle.
5. Raconter, puis vérifier #
L'étape de rédaction est découpée en quatre rôles, chacun confié au modèle le moins cher qui fasse le travail : extraire les faits saillants et les rattacher à leur empreinte de commit ; décrire le changement visuel entre deux captures successives ; synthétiser le volet technique ; rédiger le récit continu. Une cinquième passe relit le résultat contre les faits comptés à l'étape précédente et signale ce qui n'y est pas sourcé.
Les réponses sont mises en cache sur le disque : relancer la chaîne ne repaie pas ce qui a déjà été calculé. Sur un projet de deux ans, c'est la différence entre un outil qu'on utilise et un outil qu'on lance une fois.
Ce que l'exécution a trouvé et que la relecture n'avait pas vu #
L'outil lui-même a été écrit vite, par plusieurs agents travaillant en parallèle sur des modules séparés, avec un contrat d'interfaces écrit d'avance et un relecteur par module. Le code est passé en revue, et la revue n'a rien trouvé de grave. Puis nous l'avons lancé sur de vrais commits, et quatre défauts sont apparus en quelques minutes : la page tronquée par son défilement interne, une migration qui exigeait une fabrique absente à cette époque, un service d'indexation qui arrêtait l'application, un port déjà occupé.
Aucun de ces quatre n'était un défaut de logique. Tous étaient des défauts de contact avec le réel : une hypothèse sur l'environnement, pas sur le code. C'est exactement la catégorie de bug qu'une relecture, humaine ou non, ne trouve pas, et c'est pourquoi nous n'appelons jamais une fonctionnalité terminée avant de l'avoir vue tourner.
Le jalon qui n'a jamais démarré #
Sur vingt-six jalons, un seul a résisté : début mars 2025. Son jeu de migrations comporte des défauts réels — une colonne référençant un identifiant d'un autre type, une contrainte déclarée deux fois, une donnée insérée avant sa ligne parente — et les quatre commits candidats les partagent tous.
Nous aurions pu élargir la recherche jusqu'à trouver un commit qui compile. Nous ne l'avons pas fait, parce que le dépôt lui-même a tranché : cinq jours plus tard, il réinitialisait complètement ces migrations. L'échec de reconstruction n'est pas un trou dans la documentation, c'en est une ligne. Un outil de ce genre doit savoir dire « ça ne démarrait pas, et voici pourquoi » ; s'il maquille, il ne sert plus à rien.
Ce que ça coûte, ce que ça rapporte #
Comptez trois à huit minutes de reconstruction par jalon au premier passage, nettement moins ensuite grâce aux couches d'images et à un cache de paquets partagé, et une quinzaine de gigaoctets de disque. Sur vingt-six jalons, cela fait une nuit de calcul. L'étape de comptage est gratuite ; l'étape de rédaction se chiffre en quelques euros de jetons.
En face : une étude de cas illustrée par de vraies images plutôt que par des photos de banque, des décisions techniques datées quand il faut les justifier, une passation qui ne repose plus sur la mémoire de ceux qui partent, et — l'usage auquel nous ne nous attendions pas — un excellent révélateur de fragilités. Un dépôt dont on ne peut pas reconstruire l'état d'il y a six mois est un dépôt dont on ne maîtrise plus l'environnement.
C'est le genre d'outillage que nous construisons pour nos clients en même temps que leur application : intégration continue, conteneurisation et reproductibilité ne sont pas des options de fin de projet. Si votre plateforme mérite ce traitement, parlons-en — premier échange offert, devis sous 48 h.