Sommaire (7 sections)
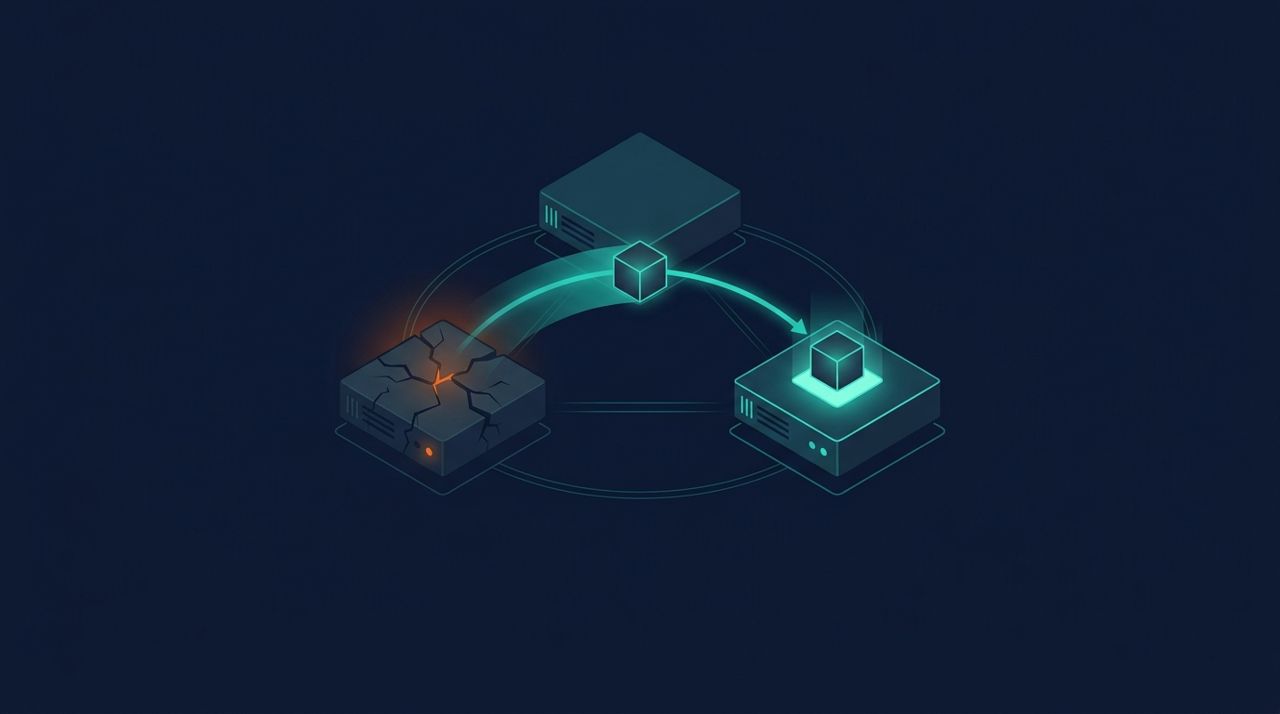
Sur le papier, la haute disponibilité Proxmox est une case à cocher : on ajoute une ressource au HA, et si un nœud meurt, elle redémarre ailleurs. Nous opérons un cluster de trois nœuds avec 31 ressources en HA (la totalité de ce qui peut l'être), et le chemin entre la case cochée et un cluster qui se comporte réellement comme prévu est pavé de découvertes. Les voici, pour vous les épargner.
D'abord, ce que le HA fait (et ne fait pas) #
Le HA Proxmox redémarre vos machines sur un autre nœud quand le leur devient injoignable. Redémarre : il y a donc une coupure, et sur du stockage ZFS local répliqué (notre cas, pas de SAN partagé), la machine repart de la dernière réplique. Avec une réplication toutes les 15 minutes, votre RPO réel est de 15 minutes : c'est le premier chiffre à connaître, et à mettre en face de ce que votre PRA exige. Le HA protège de la panne matérielle d'un nœud, pas d'un ransomware ni d'une erreur humaine, qui se répliquent consciencieusement vers l'autre nœud en moins de 15 minutes.
Corollaire structurel sur ZFS local : une machine sans réplique n'a rien à faire en HA : la bascule la démarrerait sur un nœud qui n'a pas son disque. Chez nous, la règle est mécanique : les nœuds autorisés d'une ressource HA se déduisent de sa réplication, jamais d'un choix au doigt mouillé. Et un prérequis avant même d'activer quoi que ce soit : un réseau de cluster redondant (double anneau corosync), sans quoi une simple perte réseau se transforme en fencing : le cluster « tue » un nœud sain par excès de prudence.
Le mythe : non, les conteneurs ne migrent pas à chaud #
C'est écrit dans le code de Proxmox, pas dans les plaquettes : un conteneur LXC ne sait pas migrer à chaud. En maintenance comme en bascule, un CT est arrêté, synchronisé, redémarré : comptez 10 à 30 secondes de coupure, plus le démarrage applicatif. Les VM, elles, migrent à chaud, disques locaux compris. Ce détail change le dimensionnement : un service qui ne tolère aucun blip a besoin d'une VM (ou d'une redondance applicative), pas d'un CT « en HA ». Nous l'avons vérifié dans les deux sens : nos CT font leurs 10-30 s de relocate, et une VM notoirement capricieuse a migré à chaud sans perdre une seconde d'uptime.
Les trois pièges qui nous ont coûté des heures #
1. Sans failback, les machines ne reviennent jamais #
La politique shutdown_policy=migrate évacue proprement les ressources quand on redémarre un nœud. Ce que nous avons appris à nos dépens : le retour dépend du flag failback de chaque ressource. Avec failback 0 (le défaut historique de notre configuration), un reboot de nœud s'est terminé avec neuf machines jamais revenues : le nœud vide, son voisin en surcharge, et un tableau HA affichant sereinement started partout. La dérive est silencieuse et cumulative : chaque maintenance déséquilibre un peu plus le cluster. Depuis, failback 1 partout : chaque retour de nœud coûte quelques relocates de 10-30 s, un prix assumé contre la dérive invisible.
2. La priorité la plus ÉLEVÉE gagne #
Dans une règle de placement (node-affinity), nodeA:1, nodeB:2 signifie que nodeB est le nœud préféré : le nombre le plus haut l'emporte. Lu intuitivement à l'envers, on pose exactement le contraire de son intention, et le HA déplace la machine dans la minute qui suit… ce qui, pour un conteneur, veut dire un arrêt/redémarrage immédiat. Nous sommes tombés dans ce piège deux fois en un mois, d'où cette ligne dans nos procédures : vérifier quel nombre est le plus élevé avant de valider une règle, toujours.
3. qm stop ne stoppe pas une ressource HA #
Une ressource sous HA appartient au gestionnaire HA : arrêtez-la à la main et il la considère en panne… donc la relance. Le jour où une VM gèle pendant une sauvegarde (vécu, merci les interactions entre gel de système de fichiers et logiciel de sécurité dans l'invité), le réflexe qm stop ne suffit plus : c'est ha-manager crm-command stop qui arrête proprement, en prévenant le gestionnaire. À connaître avant l'incident, pas pendant.
Ce qu'on retient #
- Le HA se conçoit depuis la réplication : RPO 15 min, nœuds autorisés = nœuds répliqués, capacité du survivant vérifiée (perdre un nœud concentre sa charge sur son voisin de réplique ; la carte de report se dessine à froid).
- CT = redémarrage, VM = migration à chaud : choisir le bon véhicule par service.
failback, priorités, arrêt d'une ressource HA : trois comportements contre-intuitifs à tester sur une machine sans enjeu, jamais découverts en production.- Et l'honnêteté du REX : la bascule sur coupure dure d'un nœud (débrancher, pas redémarrer) reste un exercice à programmer. Un cluster HA non testé est une hypothèse, pas une garantie.
Cette infrastructure porte notre hébergement souverain : bascule automatique, réplication, sauvegardes immuables et supervision. Si votre hébergeur vous dit « c'est en HA » sans savoir répondre sur le RPO ou le failback, vous savez maintenant quelles questions poser, et nous aussi.