Sommaire (7 sections)
- Le terrain : 1 706 commits, trois piles, deux bases
- Paradigme 1 : l'assistant qui complète (2024 → mi-2025)
- Paradigme 2 : le dépôt devient un contexte partagé (octobre 2025)
- Paradigme 3 : la spécification avant le code (mars 2026)
- Paradigme 4 : le débit, et ce qu'il exige (avril 2026)
- Paradigme 5 : des agents qui orchestrent des agents (septembre 2026)
- Ce que nous en retenons
Les retours d'expérience sur « l'IA qui code » manquent rarement d'enthousiasme et souvent de chiffres. Nous avons un terrain pour faire l'inverse : BuyStep, une marketplace B2B de l'énergie dont nous développons la plateforme depuis l'été 2024. Le dépôt Git garde la trace de tout ce qui s'y est passé, y compris de la façon dont l'assistance par IA est entrée dans le projet. Voici ce que ces traces racontent, sans hype.
Le terrain : 1 706 commits, trois piles, deux bases #
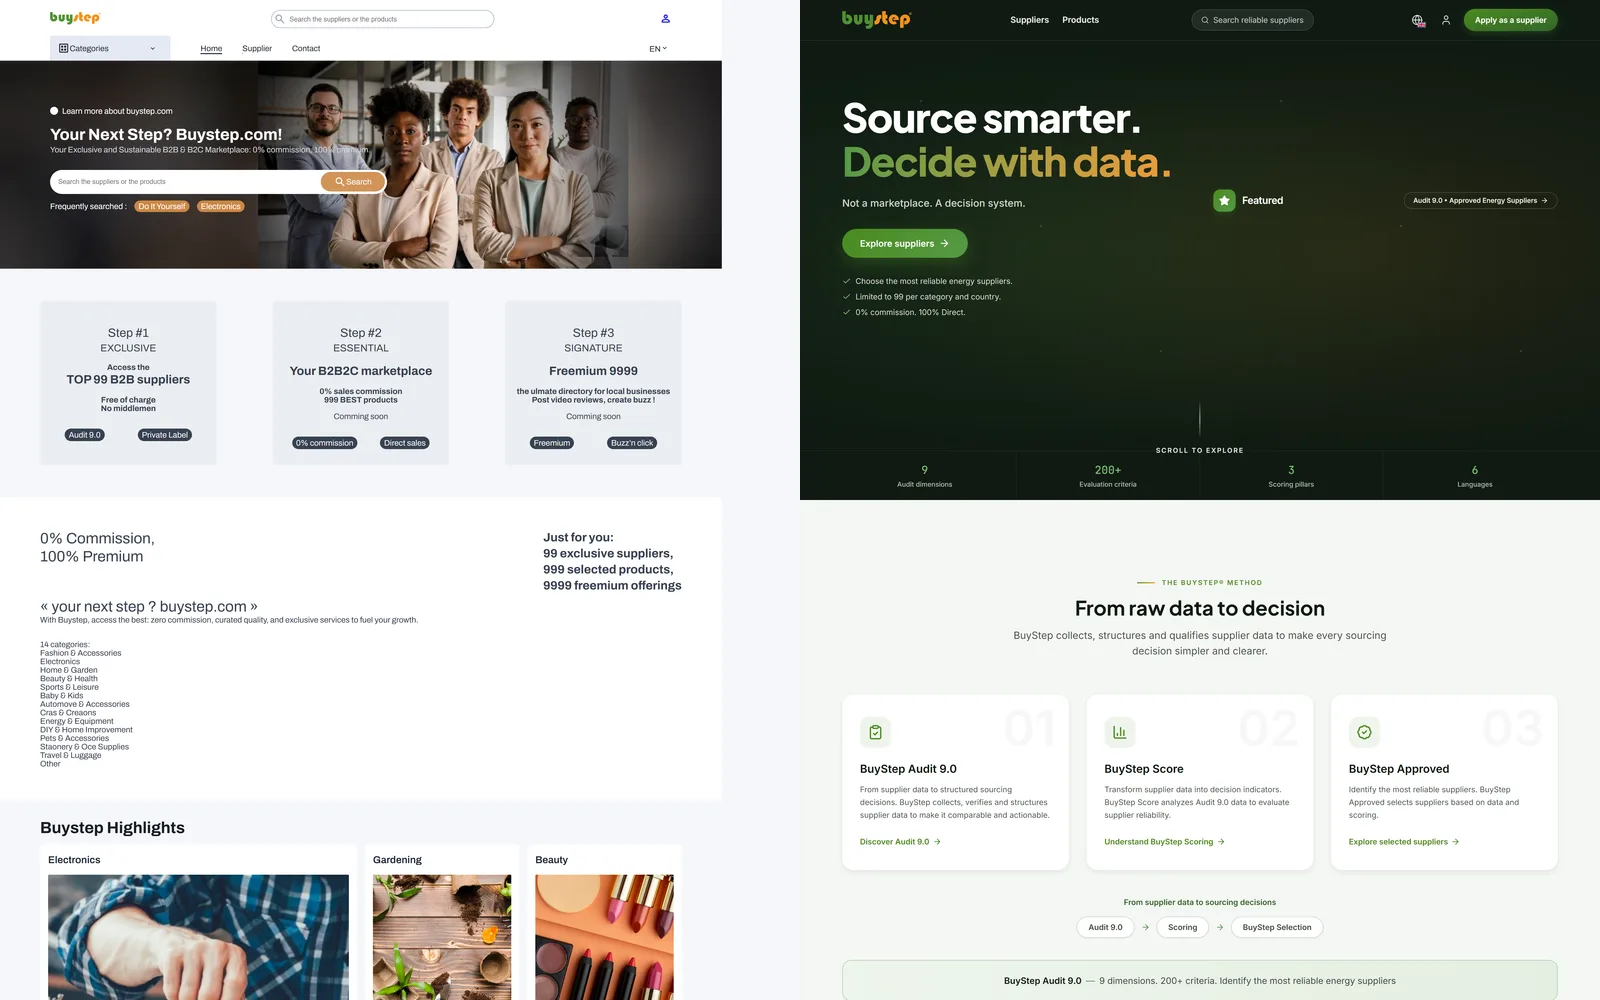
Entre le 23 juillet 2024 et le 5 septembre 2026, le dépôt compte 1 706 commits et 140 fusions vers la branche de production. La plateforme a changé trois fois de socle : un monolithe Blazor Server sur MySQL et .NET 8, puis .NET 9, puis un monorepo avec une API .NET 10, un portail Next.js 16 et PostgreSQL. Les migrations de base de données ont été réinitialisées quatre fois. Autrement dit, ce n'est pas un projet de démonstration : c'est une application métier qui a vécu.
Un indicateur simple résume la trajectoire : le nombre de commits par mois. Il oscille entre 25 et 70 pendant la première année. Il monte à 274 en octobre 2025, puis à 341 en avril 2026. Ces deux pics ne sont pas des coïncidences : ils correspondent chacun à un changement de méthode.
Paradigme 1 : l'assistant qui complète (2024 → mi-2025) #
Pendant la première année, l'IA est une aide à la frappe. Elle propose des lignes, parfois des méthodes, jamais une architecture. Le dépôt ne contient aucune trace d'elle : pas d'instructions, pas de rapport généré, des messages de commit rédigés à la main, en français, souvent dans l'urgence (« Problème d'update de folder résolu », « Changement de PC pour continuer à bosser »).
Le rythme est celui d'un développeur seul sur un produit qui cherche encore sa forme. En juin 2025, un commit annule des tests « non maintenus » : le signe classique d'une équipe qui va plus vite que ses garde-fous. Nous le notons sans le juger, parce que c'est précisément ce que le paradigme suivant a corrigé.
Paradigme 2 : le dépôt devient un contexte partagé (octobre 2025) #
En octobre 2025, trois choses apparaissent dans le dépôt la même semaine : un fichier d'instructions destiné à l'assistant (CLAUDE.md), un dossier de configuration pour lui, et une série de rapports d'analyse écrits par lui (services de l'API, migration côté client, tests des produits). Le même mois, la configuration passe entièrement en variables d'environnement, l'application est dockerisée, les migrations sont remises à plat et un jeu de données d'amorçage est écrit.
Le volume passe de 66 commits en septembre à 274 en octobre. Mais le changement important n'est pas le volume : c'est que documenter pour l'IA revient à documenter pour l'équipe. Les conventions, les commandes de build, l'architecture attendue sont désormais écrites, versionnées et lues à chaque session. Le projet est devenu lisible par quelqu'un qui ne l'a pas écrit, humain ou non.
Paradigme 3 : la spécification avant le code (mars 2026) #
Le printemps 2026 est le moment où l'exécution devient bon marché. Un dossier de spécifications versionnées (audit fournisseurs, scoring, parcours acheteurs et fournisseurs) précède le code. Un plan de restructuration du dépôt est écrit le 26 mars et exécuté le jour même : les bibliothèques partagées vont dans libs/, les applications dans apps/, l'ancien monolithe dans legacy/. Deux jours plus tard, la base passe de MySQL à PostgreSQL et le framework de .NET 9 à .NET 10. Le lendemain, les tests d'intégration abandonnent la base en mémoire pour un vrai PostgreSQL éphémère, et des tests d'architecture vérifient que les couches ne se traversent pas.
Le portail Next.js, lui, est né le 18 mars par un commit intitulé « Add base react homepage rebuild ». Un mois plus tard, il servait le catalogue, les fiches fournisseurs, l'authentification et le paiement.
Quand écrire du code coûte moins cher, la valeur remonte vers deux endroits : l'intention (que veut-on, précisément ?) et les garde-fous exécutables (comment saura-t-on que c'est faux ?). Les tests sur une vraie base et les tests d'architecture ne sont pas arrivés par hasard au moment où le volume de code généré explosait : ils sont la condition pour accepter ce volume.
Paradigme 4 : le débit, et ce qu'il exige (avril 2026) #
Avril 2026 : 341 commits, des fusions en production presque quotidiennes, des messages de commit conventionnels en anglais, une fonctionnalité entière retirée « parce qu'elle n'est plus utilisée », les mappings AutoMapper remplacés par du code généré à la compilation, l'administration Blazor remplacée par une application Next.js, et le code hérité supprimé le 12 avril. Un mois de travail qui en aurait demandé quatre ou cinq deux ans plus tôt.
Le risque de ce débit est connu : la relecture ne suit plus. Notre réponse a été mécanique plutôt qu'héroïque : des pull requests courtes, des tests unitaires qui tournent en deux secondes, des tests d'intégration en trente, une pipeline en cinq étapes qui bloque tout ce qui casse. Et une règle de conduite pour l'assistant : rapporter fidèlement. Si un test échoue, le dire avec la sortie ; si une étape a été sautée, le dire aussi.
Paradigme 5 : des agents qui orchestrent des agents (septembre 2026) #
Pour écrire cet article, nous avons construit un outil qui reconstruit les anciens commits de BuyStep dans des conteneurs Docker (SDK .NET 8, 9 ou 10 selon l'époque, MariaDB ou PostgreSQL), applique les migrations de l'époque, amorce des données, lance l'application et photographie ses pages. Il a été écrit en une session par une équipe d'agents : cinq pour implémenter en parallèle, un relecteur par module chargé de contredire, un intégrateur qui a réellement exécuté l'ensemble. Onze mille lignes en une heure.
Puis nous l'avons lancé sur de vrais commits. Quatre défauts sont apparus, qu'aucune relecture n'avait vus : une page dont le défilement se faisait dans un conteneur interne et sortait tronquée, une migration qui exigeait une fabrique EF absente de cette époque, un service d'indexation qui arrêtait l'application quand Elasticsearch manquait, un port déjà occupé par un autre projet. Chacun a été corrigé en quelques minutes, parce que le diagnostic se faisait sur une application vivante. La vérification par l'exécution reste la seule qui compte, et elle reste un travail d'humain assisté, pas un travail d'agent seul.
Ce que nous en retenons #
- Le contrat avant le code. Un document qui fixe les interfaces, les formats de données et les règles de conduite fait plus pour la qualité que n'importe quel prompt.
- Les garde-fous doivent s'exécuter. Tests sur une vraie base, tests d'architecture, pipeline bloquante : ce qui n'est pas automatisé finit par céder sous le volume.
- Documenter pour l'IA, c'est documenter pour l'équipe. Les deux publics ont les mêmes besoins : conventions explicites, commandes reproductibles, décisions datées.
- Le débit se paie en relecture et en jetons. Répartir les modèles selon la tâche et raccourcir les pull requests n'est pas optionnel.
- Rien ne remplace l'exécution. Un agent peut écrire et relire ; c'est en lançant le système que l'on trouve ce qui manque.
Nous appliquons cette méthode sur les projets que nous menons, en .NET comme en Next.js. Si vous vous demandez ce que l'IA peut apporter à votre équipe sans en faire une boîte noire, notre approche est décrite ici, et nous vous dirons honnêtement quand elle n'apporte rien.