Inhalt (7 Abschnitte)
„Souveräne KI“ wird gerade zu einem Verkaufsargument, das man auf alles Mögliche klebt. Also gehen wir das Thema anders an: Seit mehreren Monaten laufen drei unserer produktiven Anwendungen (der Assistent unseres CRM, ein Backoffice für einen Verein und ein Werkzeug zur Qualifizierung von Interessenten) auf einem Sprachmodell, das wir selbst hosten, auf unserer eigenen Maschine. Keine Demo, kein POC: Produktivbetrieb, mit möglichen Ausfällen und entdeckten Fallstricken. So sieht das in der Praxis aus.
Warum tut man sich das an? #
- Zuerst die Daten. Ein CRM-Assistent bekommt Ihre Kundendatei zu sehen; ein Qualifizierungswerkzeug liest Angebote und kommerzielle Antworten. Wer das an eine amerikanische API schickt, wirft die Fragen der Auftragsverarbeitung und Datenübermittlung auf, die wir im Zusammenhang mit dem Cloud Act ausführlich behandelt haben. Lokal verlässt nichts das Haus, die Frage stellt sich nicht mehr.
- Planbare Kosten. Eine API rechnet pro Token ab, und ein gesprächiger Assistent an einem CRM verbraucht schnell viel. Eine abgeschriebene Maschine kostet gleich viel, ob sie zehn oder zehntausend Anfragen bearbeitet.
- Unabhängigkeit. Kein Modell, das von heute auf morgen abgekündigt wird, keine Bedingungen, die sich ändern, keine überraschenden Kontingente. Das Modell, das wir freigegeben haben, ist das, das läuft, Punkt.
Der Ehrlichkeit halber gehört auch die Kehrseite dazu: Ein Open-Weights-Modell mit rund dreißig Milliarden Parametern ist kein großes kommerzielles Modell der neuesten Generation. Bei komplexem Schlussfolgern oder anspruchsvollem Schreiben liegen die Spitzenmodelle weiterhin vorn. Das Selbsthosten gewinnt bei klar abgegrenzten Aufgaben (zusammenfassen, extrahieren, klassifizieren, qualifizieren, Werkzeuge aufrufen), die in der Praxis den Großteil des KI-Bedarfs einer Geschäftsanwendung ausmachen.
Die Architektur: eine Maschine, ein Gateway, drei Abnehmer #
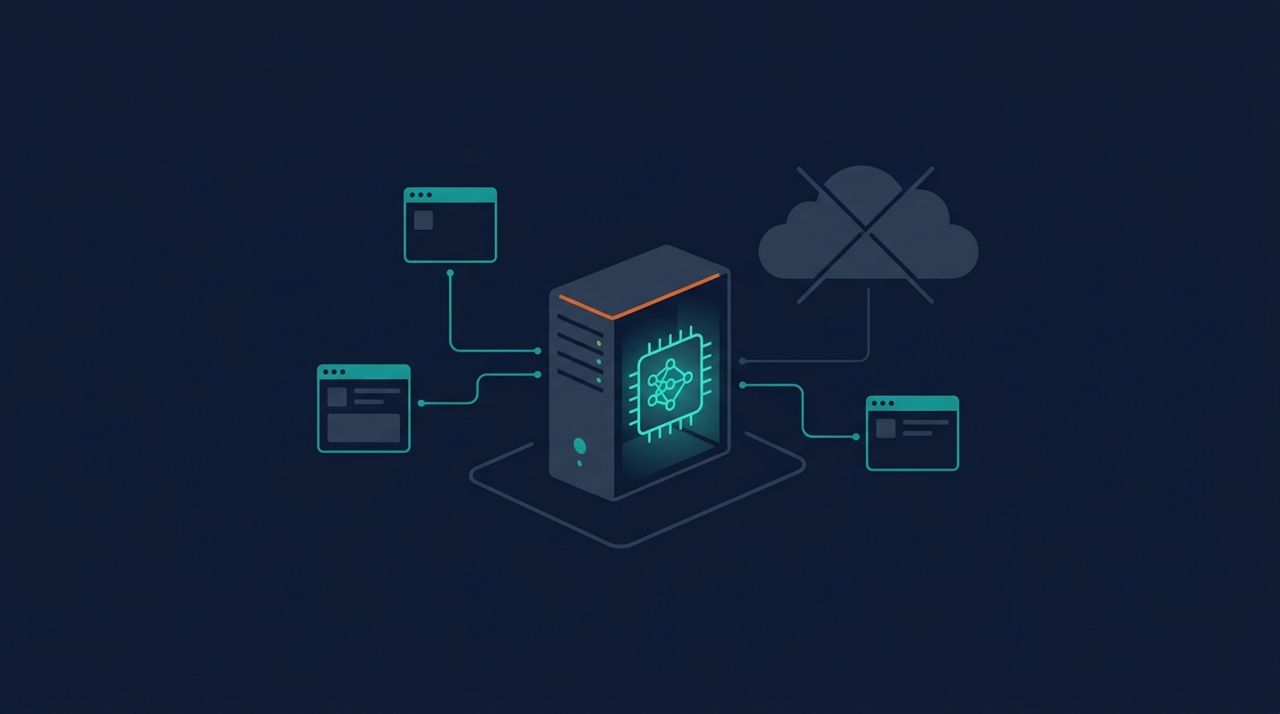
Der Aufbau besteht aus drei Ebenen. Eine dedizierte GPU-Maschine betreibt das Modell über llama.cpp (llama-server), das eine OpenAI-kompatible API bereitstellt, den De-facto-Standard, den alle Clients sprechen. Davor bündelt ein Gateway (bei uns OpenWebUI), was der Modellserver nicht verwaltet: Konten und API-Schlüssel pro Anwendung, eine strikte Zugriffsliste (ein unbekannter Aufrufer erhält ein 404, keine Anmeldemaske) und Protokollierung. Die Anwendungen kennen nur das Gateway, nie die GPU-Maschine: Modell, Maschine oder Engine lassen sich wechseln, ohne den Code der Abnehmer anzufassen.
Die Fallstricke, die die Theorie nicht vorhersagt #
Strukturierte Ausgaben, die das Modell verrückt machen #
Tool-Calling (ein LLM, das die Funktionen Ihrer Anwendung aufruft) beruht auf JSON-Schemas. llama.cpp wandelt diese Schemas jedoch in eine formale Grammatik (GBNF) um, die jedes erzeugte Zeichen hart einschränkt. Und manche vollkommen gültigen Schemas ergeben tückische Grammatiken: Ein leeres Teilschema additionalProperties: {} (wie es sehr verbreitete Validierungsbibliotheken erzeugen) wird als „Objekt erforderlich“ interpretiert: Das Modell wird unfähig, an dieser Stelle eine Ganzzahl oder ein Array auszugeben, liefert absurde Aufrufe, die Anwendung lehnt sie ab, das Modell versucht es erneut… Endlosschleife. Diagnose: Stunden. Korrektur: ein Filter im Gateway, der die Schemas umschreibt, bevor sie die Engine erreichen. Die Lehre: Beim Selbsthosten gehört Ihnen die Grenze zwischen Ihren Schemas und der Generierungs-Engine, im Guten wie im Schlechten.
Die Temperatur zählt mehr als der Prompt #
Unser Qualifizierungswerkzeug bewertet Verkaufschancen. Erste Feststellung im Produktivbetrieb: Zwei Durchläufe auf denselben Daten wichen im Schnitt um 30 von 100 Punkten voneinander ab, genug, um eine Entscheidung kippen zu lassen. Zuerst haben wir den Prompt verfeinert, ohne großen Effekt. Der eigentliche Hebel lag woanders: die Temperatur der Generierung, von 0,2 auf 0 gesenkt. Mittlere Abweichung danach: weniger als ein Punkt. Bei jeder reproduzierbaren Bewertungsaufgabe wiegt diese einzeilige Einstellung mehr als Stunden an Prompt-Engineering, und so etwas entdeckt man nur, wenn man misst.
Der SPOF, bewusst in Kauf genommen und überwacht #
Eine einzige GPU-Maschine = ein Single Point of Failure. Wir nehmen das in Kauf, weil der eingeschränkte Betrieb akzeptabel ist: Fällt das Modell aus, verliert das CRM seinen Assistenten, nicht seine Daten oder Funktionen. Das ist eine ausdrückliche Abwägung: Überwachung der Maschine, dokumentierte Kritikalität und keine lebenswichtige Funktion, die am LLM hängt. Die allgemeine Regel: Selbst gehostete KI soll Ihre Anwendungen bereichern, nie Voraussetzung für ihren Betrieb sein.
Wo anfangen #
- Eine klar abgegrenzte Aufgabe mit klarem Nutzen: Zusammenfassung von Datensätzen, Extraktion von Feldern, Sortieren von E-Mails, Qualifizierung. Nicht „ein Chatbot, der alles kann“.
- Ein einziges, gut gewähltes Modell, bewertet auf Ihren Daten, statt eines Modellzoos, der sich nicht pflegen lässt.
- Ein Gateway vom ersten Tag an: Authentifizierung, Allowlist, Protokollierung und die Indirektion, die es Ihnen später erlaubt, dahinter alles auszutauschen.
- Messungen: Reproduzierbarkeit, Latenz und Fehlerquote stellt man fest, man unterstellt sie nicht.
Genau das ist der Umfang unseres Angebots zur KI- und LLM-Integration: ein Modell (bei uns in Frankreich selbst gehostet oder per API, wenn das die richtige Wahl ist) mit den oben beschriebenen Schutzmechanismen an Ihre bestehenden Anwendungen anbinden. Eine wiederkehrende Aufgabe, die einen Versuch wert wäre? Beschreiben Sie sie uns.