Sommaire (4 sections)
Les pannes de disque des films sont binaires : ça marche, puis ça meurt. Les vraies pannes sont plus retorses. Celle-ci a dégradé un hyperviseur de production pendant deux mois et demi sans jamais rien « casser » : pas de disque hors service, pas de données perdues, pas d'alerte rouge, juste des timeouts sporadiques la nuit, et un composant de quelques millimètres qui avait cessé de faire son travail. Autopsie complète, parce que ce mode de panne guette n'importe quel serveur.
PLP : le composant dont personne ne parle #
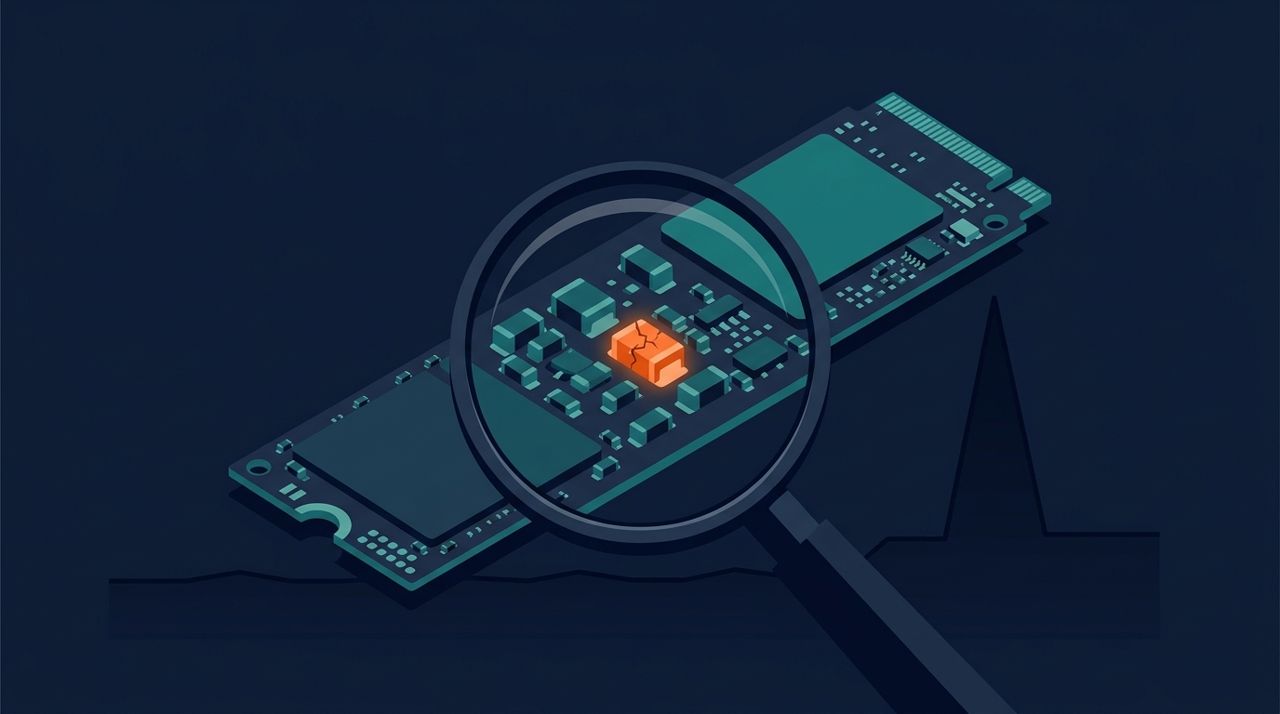
La Power Loss Protection est ce qui sépare un SSD d'entreprise d'un SSD grand public. Un SSD honore les écritures « sûres » (sync) de deux façons : soit il écrit réellement en NAND avant de répondre (lent), soit il répond depuis sa DRAM et s'engage à finir le travail, une promesse qu'il ne peut tenir en cas de coupure de courant que grâce à une réserve de condensateurs embarqués qui lui laissent les millisecondes nécessaires pour vider son cache. Ces condensateurs, c'est la PLP. Sans elle, un SSD qui veut rester honnête doit désactiver son cache d'écriture sync, et ses performances s'effondrent. Pour un système de fichiers comme ZFS, qui multiplie les écritures synchrones, la PLP n'est pas un luxe : c'est la condition des latences annoncées.
Le symptôme : des timeouts la nuit, et rien d'autre #
Tout commence par des échecs de réplication ZFS : zfs snapshot … got timeout, sporadiques, concentrés dans une fenêtre d'une poignée de minutes chaque nuit, pile quand des sauvegardes applicatives chargeaient les invités en écritures. Deux cent quarante-six échecs accumulés avant que l'enquête ne remonte à la source. La mesure qui a tout révélé : la latence d'écriture des deux NVMe du miroir. Le disque sain répondait en 52 microsecondes ; son jumeau, en 4 à 6 millisecondes, cent fois plus. Et un miroir avance au rythme du plus lent : tout le pool attendait.
smartctl -H /dev/nvme1
# SMART overall-health self-assessment test result: FAILED!
# - volatile memory backup device has failed

smartctl -a /dev/nvme1 | grep -i critical
# Critical Warning: 0x10   <- bit 4 : défaillance du backup de mémoire volatile

# Et pourtant, la NAND était SAINE :
# Percentage Used: 5% · Media and Data Integrity Errors: 0
Le verdict SMART tient en une ligne : volatile memory backup device has failed : les condensateurs PLP étaient morts. Le contrôleur, honnête, avait désactivé son cache d'écriture et encaissait chaque sync à vitesse NAND. Le disque n'était ni mort ni mourant : sa NAND affichait 5 % d'usure et zéro erreur. Un composant de sécurité avait lâché, et la seule trace était une ligne SMART que personne ne lit… puisque le disque « marche ». La date de première apparition du défaut dans les journaux : onze semaines avant le diagnostic. Leçon numéro un : superviser le détail SMART (le health status et les Critical Warnings), pas seulement « le disque répond ».
Le remplacement : ce qui se passe vraiment chez un hébergeur #
Sur un serveur dédié, on ne change pas le disque soi-même : on ouvre un ticket chez l'hébergeur (OVH en l'occurrence) avec le numéro de série du disque et le rapport SMART, on planifie le créneau, un technicien du datacenter remplace le disque. De notre côté, la remise en service d'un membre de miroir se déroule en quatre gestes, chacun avec son piège :
- Recopier la table de partitions depuis le disque survivant :
sgdisk -R <destination> <source>puis-Gpour régénérer les GUID. Piège classique : l'ordre des arguments est destination d'abord : inversez-les et vous écrasez la table du disque sain. - Réintégrer chaque couche : les partitions md (
mdadm --add), le swap recréé avec son UUID d'origine (mkswap -U …) pour que la configuration existante le retrouve au boot. zpool replacesur la partition ZFS : le resilver a recopié 218 Go en cinq minutes.- Vérifier l'énumération : au reboot suivant,
/dev/nvme0et/dev/nvme1avaient échangé leurs noms. Tout ce qui référence un disque doit le faire par identifiant stable (/dev/disk/by-id/, numéro de série), jamais par numéro d'énumération.
Résultat mesuré après remplacement : 236 µs de latence d'écriture, symétrique sur les deux disques, sous près de 4 000 IOPS. Les timeouts nocturnes ont disparu le soir même.
Le twist final : 20 000 erreurs qui dormaient #
Le resilver a eu un effet secondaire précieux : c'était la première relecture intégrale du pool depuis sa création. Et cette relecture a exhumé plus de vingt mille erreurs de checksum sur des données froides : d'anciennes répliques figées, jamais relues depuis des mois, dont la corruption n'avait donc jamais été vue. Aucune donnée de production n'était touchée, le nettoyage a suffi ; mais la leçon est exactement celle de notre article sur les scrubs, écrite ici en lettres de feu : une donnée jamais relue peut être corrompue depuis des mois sans qu'aucun voyant ne s'allume. Depuis, scrub mensuel planifié et vérifié sur chaque nœud : la panne aura au moins payé sa leçon.
Cette traque (corréler des timeouts nocturnes, une fenêtre de sauvegardes et une ligne SMART) est le quotidien de notre infogérance : la fiabilité n'est pas l'absence de pannes, c'est de les voir avant qu'elles ne coûtent. Si vos serveurs ont plus de deux ans et que personne n'a jamais lu leur SMART en détail, c'est le moment.